爱吱声

标题: DeepSeek R1全参数模型一个可能的本地部署方案 [打印本页]

作者: 沉宝    时间: 2025-2-20 15:41
标题: DeepSeek R1全参数模型一个可能的本地部署方案
DeepSeek一夜爆火,现在联网服务拥堵不堪。当晨老大号召自建farm的时候,本人开始认真考虑本地部署。 KTransfomer的报道也在第一时间见到,并设想了一个以此为基础的装机方案。然后呢,就“铲后抑郁”了。如今很多内容都在网友[大黑蚊子]的记录(链接)中讨论过了,但具体的装机方案大概还有一些价值,还是写出来吧。( _- N) L! {) c5 k# D
6 ^8 ~9 c* l3 j9 e2 D7 o+ p3 @3 ]3 p
DeepSeek R1原版是一个参数量高达671B的大模型,虽然比之其它頂尖的人工智能模型在硬件要求上已经大大降低,但个人部署全尺寸模型,依然难度不小。为了便于在低端硬件上运行,出现了一系列蒸馏版减少参数量(以 Qwen2.5 或 Llama 为构架,参数范围从 1.5B、7B、8B、14B、32B 到 70B)。另一个思路是参数量化,例如1.58bit和4bit。一般来说,LLM训练时使用高精度(例如 32位浮点数),而推理时使用低精度(16位浮点数或者更低)即可。1.58bit是把这一趋势推到极端(只有0、1和-1三种状态)。有人试验了DeepSeek全尺寸模型的1.58bit的量化版,结论基本可用,有时候说话可能有点“冲”,圆润平衡上差一些。4bit版效果已经相当好了。至于[xiejin77]担忧的量化影响反馈精度或者稳定性,理论上有可能,但实际影响需要大量的对比实验加以证实或者证伪。
$ J+ j/ {6 c1 d4 ]3 g4 N# q. T  S3 y, V: t7 k9 h
下面讨论具体装机方案。首先定一下目标。目标用户:个人或者小团体。鉴于这个模型现在典型的应用场景都是文字的输入和输出,跨网络合用的难度并不大(因为不需要占据太多的网络带宽)。单机,预算定位$5000左右。应该属于一个人咬咬牙能冲得上去,小范围集资(10人以内的那种)能够轻易支付。目标性能:DeepSeek R1全尺寸671B的4bit量化版,输出速度与人的阅读速度差不多即可(个人使用,太快了没有必要),约 5-10 tokens/s。这样的预算,这样的目标,显然需要KTransfomer技术加成才有可能达到。饶是如此,也得按市场最低价加DIY省着来。8 k" l/ q& t8 Y9 O8 u
3 Q& @1 c6 x" m
第一步:内存的大小。将模型的参数全部放入内存是必须的。如果还用硬盘空间扩展出来的虚拟内存,那速度肯定慢的不行。DeepSeek参数精度16bit(BF16)时需要 1342GB的存储空间,4bit量化版所需空间为其¼,再加上程序和操作系统所需,512GB应该可以了。这么大的内存,普通PC机主板肯定不行,要上服务器的。鉴于当前DDR4的内存条比 DDR5还是要便宜不少,所以选择DDR4。: x1 H7 {, q/ P: C- h4 v! X

9 s9 n: Q" i' G1 p2 {- W: z: z第二:CPU和主板。CPU我选AMD Zen3架构( Zen3是DDR4的最后一代)的服务器芯片EPYC 7C13, 64 core 128 threads, 市场价仅$700+。它与正式发布的7713结构一致,频率略低,有人怀疑类似于Intel的 ES(工程样品)。主板支持Milan的SP3主板即可。唯一要注意的是内存插槽数,根据DDR4单条内存的容量大小,要能够插出512GB来。
7 U  F9 T7 z6 i) l: ~5 x% W3 ^& F; Q) z9 a4 G' q- w

( N6 Q, @% D; M第三:显卡。双3090或者单4090。4090不好买,用两块3090大致能抵上一块4090。
8 K# p) n# C) d/ D$ q7 J1 k4 N3 f4 k+ D/ ^8 Z
第四:硬盘。这个要求真不高,如果机器仅仅是为了跑DeepSeek,一个4 TB3 }+ P4 n. j* J# N3 N! i  Z
(或者两个2 TB)的nvme就够用了。(想当初我在爱坛上发记录推荐固态盘时,一块4TB的才$150)
5 a+ h6 X3 S; n8 M
* @, }' H5 s! x9 [4 }* [7 J, {其它:说3点。1)普通PC机箱。2)散热避免使用服务器的暴力风扇( PC机箱也缺乏服务器的风道结构)。如果散热量大,考虑用水冷。3)如果单台大功率电源太贵,可以用两台小的给主板和显卡分别供电。如此需要双电源同步启动板或者同步线,但那东西淘宝上也就人民币10块钱。# ?) m2 U& C. x/ c! d" M% c5 L
( l/ I7 Z2 w/ G/ a/ Z- F; M2 Q/ W8 D
最后汇总一下。数字为能够淘到的大致美元价,可以接受二手货,+、-表示向上下浮动不超过15%- {4 H4 j9 z$ f" H
# S- m9 _# R& O( z3 [# V/ b5 H
RAM 512GB DDR4       1000+. L. R8 i9 W$ ?, m3 Y/ ~; D
CPU 7C13或相当           700+
: l& j$ [9 [5 s主板(单路即可)         500
  A. Z7 O' K7 g  |  }- t显卡 3090                  1000- ×2
" x: P% I2 T. N$ G" b固态硬盘                     200+
! V  p/ c. E: N  x. K" _其它 机箱、电源、散热器等
- ?/ G( R, n9 W9 \1 l  ^
6 l3 G6 D3 l+ }* b6 Z0 S, h3 u: A# N
作者: 大黑蚊子    时间: 2025-2-20 16:27
本帖最后由 大黑蚊子 于 2025-2-20 21:55 编辑
! @" w, q8 e3 _/ m7 Z# E  Y
9 z, u3 |! [% x( r6 b) q, N2 _说实话我也在琢磨这个玩意儿,几万块钱搞一个这个玩玩,在AI新浪潮初期真的算是一个比较高性价比的学习途径了# q& ]- E9 `; B2 P8 N. J( F
在硬件选型上面我倒是有点儿不同意见,鉴于章明星他们在0.3版里使用amx指令集加速,那么支持amx的Intel至强可扩展CPU应该是要好于AMD的EYPC的,具体来说现在Intel最新款是6代至强,退而求其次选择四代或者五代至强应该也满足要求。章明星团队他们的硬件好像也是双路Xeon 6430* f3 N) Q' F6 e+ A
但是这个成本可能要比你说的EPYC要高不少,但总的来说应该还在可承受的范围之内
) h6 ~# O! g* G/ z显卡的双路配置好像不是特别必须的,主要是4bit量化版需要14g显存,所以如果有一块3090先用着应该问题也不会太大,实在不行多买一块也可以: x# }* t% y9 w7 m7 ^4 w% B

2 {% [* g6 _3 h5 z  G  u周末去华强北转转去,看看二手服务器有啥准系统能够直接上手的
作者: 马鹿    时间: 2025-2-20 21:42
我看到了国内AI的商机。。。 攒小配置的AI模型!
作者: 马鹿    时间: 2025-2-20 21:43
关于方案, 我直接问过deepseek。。。
作者: 马鹿    时间: 2025-2-20 21:45
大黑蚊子 发表于 2025-2-20 03:27
9 E  E& }1 g( w& G. v! p说实话我也在琢磨这个玩意儿,几万块钱搞一个这个玩玩,在AI新浪潮初期真的算是一个比较高性价比的学习途径 ...

) z8 U/ q$ O0 V6 Z" Y) ~2 z真心羡慕国内了。。。我90年代自己攒过打游戏的计算机。。。
作者: testjhy    时间: 2025-2-20 22:50
马鹿 发表于 2025-2-20 21:45! c$ A/ U# v, w
真心羡慕国内了。。。我90年代自己攒过打游戏的计算机。。。

# M/ H: V- `' L社长,美国不是与国内PC价格差不多吗?也仿照沉宝蚊行攒一台呗,
作者: 马鹿    时间: 2025-2-20 23:19
testjhy 发表于 2025-2-20 09:50  \' B- f7 z- W" D4 s8 l6 g
社长,美国不是与国内PC价格差不多吗?也仿照沉宝蚊行攒一台呗,
2 Q7 U# K5 w; Y# C: ?' K' j6 E: H攒了以后干啥呢?
作者: testjhy    时间: 2025-2-20 23:32
本帖最后由 testjhy 于 2025-2-20 23:41 编辑 * w6 M' F4 M0 ?3 \

) O  B5 P& ^9 V- T5 D1 V+ @  B. b' h) ?5 {- y4 `$ R. \+ O3 O: D1 g
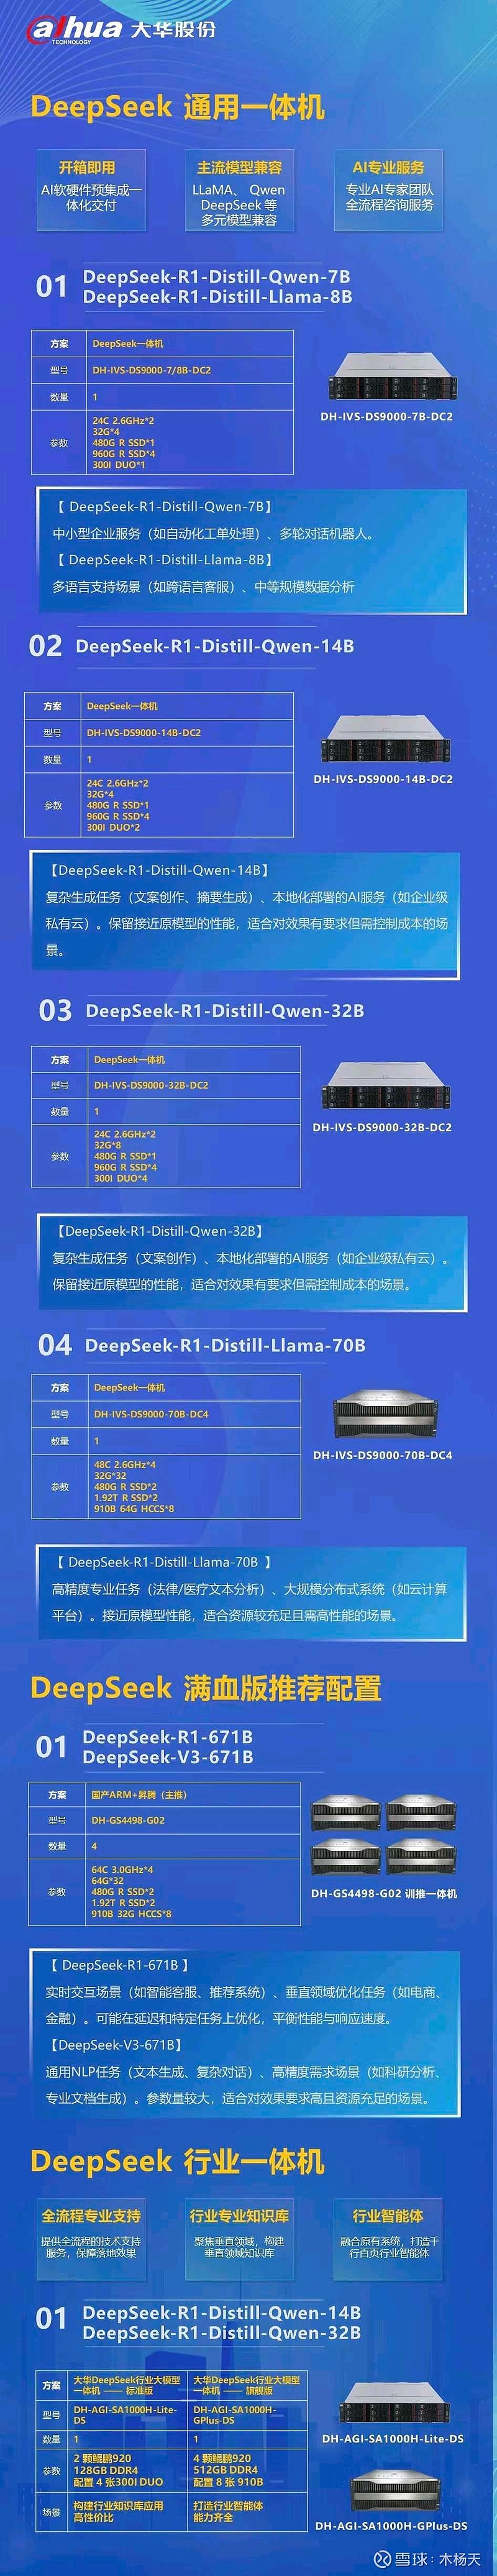
这是大华股份根据国产芯片的一体机,估计是华为提供的方案供各家贴牌
作者: 大黑蚊子    时间: 2025-2-20 23:38
testjhy 发表于 2025-2-20 23:32
- X, m* A* w+ ]8 i5 P) e3 L2 z这是大华股份根据国产芯片的一体机,
% [9 T+ u2 B+ A; p' B' P7 y& g8 w
大华的这个配置没啥意义,你看跑的都是蒸馏版的7B/14B/32B模型' ~1 U1 z$ ^: g' b; \5 y- g: J
我在自家电脑上搞了一个7B的模型试了下,真的是不太行
  L$ B3 A& D1 m9 k: W$ ?  o8 w! Z我估计32B和70B也都不太行8 z8 [. }3 I" l  w0 a2 ~7 d# C
这个帖子里讨论的应该是直接上手671B的满血量化版,1.58或者4bit版本,这个据多个信源反馈效果挺好的1 w6 L# _+ Q$ b! a$ m
; s! W: m! }. O, I" w

( s1 _$ H- `: v, T0 @5 R不过这个单子我倒是可以拿着去嘲笑下大华的朋友“你们钻钱眼里了?搞这个文字游戏骗钱”
作者: testjhy    时间: 2025-2-20 23:42
马鹿 发表于 2025-2-20 23:19
: p' @9 b2 @4 Z. R( N攒了以后干啥呢?
3 ]% H  i( B2 b0 F0 [
想干啥就干啥,吃喝玩乐,
作者: testjhy    时间: 2025-2-20 23:45
大黑蚊子 发表于 2025-2-20 23:38
$ ]5 a" \; T( B9 U5 c大华的这个配置没啥意义,你看跑的都是蒸馏版的7B/14B/32B模型! l) t3 P+ U" ~  ?$ j
我在自家电脑上搞了一个7B的模型试了下, ...

: [" X7 c5 z2 a9 e/ ]4 w找了一个非剪裁图,看了一个新闻,华为提供方案,有60多家企业响应,大华可能是比较快的,找不到价格,
作者: 大黑蚊子    时间: 2025-2-20 23:53
testjhy 发表于 2025-2-20 23:45
8 p8 X4 m( O- t. ]8 G% `找了一个非剪裁图,看了一个新闻,华为提供方案,有60多家企业响应,大华可能是比较快的,找不到价格,{: ...
4 U' b) t4 \0 b
我要是鼓捣这玩意儿,肯定是找二手硬件啥的,全新设备的价格那还是相当辣手的/ v1 q0 E: V5 N6 q
打听了一下Intel的至强4代CPU,现在全球缺货,嘿嘿
# u' h: g0 G2 j8 ?: z; C去华强北看看有没有QS版本,可能一块就要6000人民币至少
作者: 马鹿    时间: 2025-2-20 23:53
大黑蚊子 发表于 2025-2-20 10:38
( g" |. L2 h1 c5 S3 H. T大华的这个配置没啥意义,你看跑的都是蒸馏版的7B/14B/32B模型
" y6 a4 I, M: B/ j# g8 n& J我在自家电脑上搞了一个7B的模型试了下, ...

5 f8 W+ C, b) I) a+ b* C好奇你攒个模型做啥?
作者: 大黑蚊子    时间: 2025-2-21 00:03
马鹿 发表于 2025-2-20 23:53
* V* E6 D! @! {好奇你攒个模型做啥?

; V* k8 y4 _2 _7 m. l1 P- t6 y; f' t8 e" P( s# O
玩啊,好奇啊,这很可能是通向新世界的大门
/ t+ u( _4 [8 W0 g& V有这个条件的话,干嘛不玩?; G1 H& U$ ?- A. d: q* _

" q! b; B. P. S, H+ S! D1 F现在大部分人还在懵逼状态中,只是知道个大模型的东西,具体怎么搭,个人知识库怎么建,私有服务怎么处理...好玩的需求多着呢
- ?5 Z. n2 q6 N$ f% n5 V. x8 R" v2 C6 }! N1 a
DeepSeek的出现,极大降低了大模型训练和部署的总体成本4 ?8 G& D! s. A, M. V$ x/ Z& m! l. p8 h# H
KTransformer架构的出现,打响了极大降低大模型部署和私有知识库服务的硬件成本的第一枪
, O+ s7 Z' F% B+ F% S/ r/ @* T
" f0 F6 u, g4 ?, [/ S这种能够降低90%成本的新技术出现,大概率后面会蕴藏着10亿级别的新的相关应用和服务空间
0 H% r4 i+ ~8 ]6 m玩的过程中也可以吸收很多其他的知识,认识其他稀奇古怪的人,包赚的啊
作者: 沉宝    时间: 2025-2-21 00:16
大黑蚊子 发表于 2025-2-20 16:27
! j% J# o9 H6 I/ [说实话我也在琢磨这个玩意儿,几万块钱搞一个这个玩玩,在AI新浪潮初期真的算是一个比较高性价比的学习途径 ...
1 {4 J3 |9 b6 q$ J$ k
这取决于对问题的理解和取舍。首先在大模型计算中,GPU的能力远远强于CPU,即使那个CPU有amx指令加速。所以在预算有限的前提下,应该尽量省下钱来加强GPU。当然如果实测一块3090够用了,那更好。% c2 r1 h- {  z

/ z% W: b" b: h8 G1 y7 a* q. ]# |对比EPYC与Xeon 6530方案。Xeon 6530 2023年底发布,还比较新,主板加CPU的折扣有限。而EPYC Milan则要旧得多,有大批从数据中心退下来的二手货可选。即便有amx加成,但架不住7713的核多,单挑的话还是应该7713赢。而双路7713的话只不过比我的原方案多一颗U的钱,其它几乎不用改。个人认为CPU的第一位作用是保障参数全部装载在内存,计算加速还在其次。章明星团队的努力是充分挖掘手头现有硬件的全部潜力,amx加速是新版才加上去的,可见并非重中之重。
作者: pcb    时间: 2025-2-21 01:42
大黑蚊子 发表于 2025-2-20 23:539 `- D% t4 H- N. z
我要是鼓捣这玩意儿,肯定是找二手硬件啥的,全新设备的价格那还是相当辣手的
; I3 D6 P* P. U& }* i" C  i打听了一下Intel的至强4代C ...
$ v2 ]5 J0 `1 k0 F& b
"至强" 是 Xeon?
作者: 马鹿    时间: 2025-2-21 02:29
大黑蚊子 发表于 2025-2-20 11:03# w0 M6 K# [0 [. \* N, P
玩啊,好奇啊,这很可能是通向新世界的大门) X6 X* ?! h& u! \( J
有这个条件的话,干嘛不玩?
$ H0 L& y; Q  g/ {6 f9 i& |
握手, 我也是,就是好奇。 也同样认为这是通向新时代的大门。
作者: xut6688    时间: 2025-2-21 05:30
在本地部署满血版的DeepSeek R1, 性价比太低了,还不如用各个云厂商的API。 自己学习,玩一玩用云API就好。至于本地部署的蒸馏R1,我试过各个版本包括70B的,效果都不好,和原版差太远。我自己玩着用本地部署的模型做了一个RAG应用,最后发现蒸馏R1还不如原版的QWen2.5 32B。
作者: 大黑蚊子    时间: 2025-2-21 09:06
xut6688 发表于 2025-2-21 05:304 k' [5 c  X. l) ~) N
在本地部署满血版的DeepSeek R1, 性价比太低了,还不如用各个云厂商的API。 自己学习,玩一玩用云API就好。 ...
/ W3 N7 |9 a8 Q0 Z* a  L# E9 I
所以为啥盯着671B的版本呢,就是这个原因,其他版本的性价比其实都不好。9 i" |5 R; j* A1 g7 ~

7 P, m" ~( X0 l* L8 L2 v目前有海量的本地部署满血版DeepSeek的需求,因为太多的数据受商业或者法规的限制不能上网,这个部署的整体过程是有很大市场需求的。
# C  B  o# A3 u% q( |
  N" I9 |% z1 L& c6 t0 k6 o; SDS和KT的诞生,不是拉低了对算力的需求,而是通过降低成本做大了整体算力需求。
2 f3 j* B/ v: d) p( b0 j' ]9 N, b+ P5 q: O3 a7 _! q
而且部署过程中的调优和配参,踩过的坑,以及反复琢磨和资料学习的成果都是自己的。: e, M  \! F& A5 L& \- G
( u; T5 O7 W1 b0 B. X# Z
再说了,都是二手硬件,搭完之后上闲鱼卖掉,亏不了多少钱
作者: 大黑蚊子    时间: 2025-2-21 14:10
沉宝 发表于 2025-2-21 00:164 {" }8 }8 D) \# N8 o
这取决于对问题的理解和取舍。首先在大模型计算中,GPU的能力远远强于CPU,即使那个CPU有amx指令加速。所 ...

  Y2 g9 N# C6 t' H/ k: [! \( N我建议你再看一下KTransformers的相关资料% e% r- p2 p! m$ K5 l
这个玩意儿的本质是在低并发(甚至是单并发)的情况下,高度依赖CPU/DRAM带宽,从而降低GPU需求的降本做法。. ^3 W4 v- X4 m+ J
DDR5换DDR4的话,带宽砍半,对应token的数量就要起码减半
) D0 m3 b9 l% Y& [CPU的带宽再砍半的话,又要丢失速度
( _1 A' n0 w% e  m2 _0 @! q) {如果CPU/DRAM带宽不够的话,甚至3090可能都喂不满,无限下降螺旋在降低成本的同时会极大影响使用效果" O& ~" c* l2 Q) U+ |6 k/ ?- a
对于咱们来说,跑起来不是胜利,能够最低限度可用才是核心需求所在啊
& T  A" ]5 h- n# Q8 \  y  @! `1 \0 G我觉得起码要搞个输出4-6token/s才行吧+ h$ }2 C7 |) V9 x
按你这个方案我估计可能1-2token都悬
作者: 沉宝    时间: 2025-2-22 00:10
大黑蚊子 发表于 2025-2-21 14:10
' Z- G& H# ^! Y; G* P/ E8 ^" u6 z我建议你再看一下KTransformers的相关资料* ]/ U) t, [3 k- a5 g% V
这个玩意儿的本质是在低并发(甚至是单并发)的情况下,高度依 ...

: f# ^3 L0 t5 f1 N( i9 F欢迎讨论。$ a( k5 s' y0 _1 H

8 i# J4 k- q" M9 g: |8 W首先,个人以为KTransformers的最核心最精华的是抓住了DeepSeek模型参数的稀疏性。DeepSeek是基于MoE的,回答某一个具体问题时只有部分参数高度活跃。KTransformers可以动态调度,把这部分高强度计算交给GPU(好钢用在刀刃上),剩下的则由CPU完成。所以CPU部分对系统整体性能的影响不如GPU大。作为佐证,上一帖我提到了章明星团队在几次版本迭代更新之后才把amx加速添加上去。4 M+ F: R" l2 \7 X/ h
7 e8 A' y* S1 _6 {4 ~
CPU/DRAM带宽对系统性能的影响不是简单线性的。老实说,我没有咱们现在讨论的这样大的系统的实际经验。我只能根据在台式机上看到的现象做一些外推。Intel的12代和13代同时支持DDR4和DDR5,DDR5内存下整体成绩要比DDR4好一些,不过差距并不大。至于到显卡的带宽,我也可以说一点。我们知道目前大部分显卡的插座都是PCIe×16。外置显卡时,因为各种原因往往不做16路通道,比方说仅仅实现了8位通道。那么这个PCIe×8的显卡游戏性能下降多少呢?绝对在30%以内,常常也就10-20%。# V  \. U3 k4 I

$ q% [' c* h( x3 q9 }( S0 x以上这些是我没有简单照搬章明星团队的配置,而为省钱做了一些变更的原因。
作者: 大黑蚊子    时间: 2025-3-10 22:25
沉宝 发表于 2025-2-22 00:10
( `2 C) t, w/ r% v9 j( \) Y" p/ A) ^% ^( b欢迎讨论。
) [- M0 p, p: n3 `) M2 c1 b: k' X
首先,个人以为KTransformers的最核心最精华的是抓住了DeepSeek模型参数的稀疏性。DeepSeek ...

0 ]0 `% b' E# R刚刚看到一个案例,有个朋友用2686V4 x2 加256GDDR3跑起了671B的Q2.51版本: A2 W: A1 n/ `6 `( X1 n; U! @( i# q6 J% t
显卡用的是3070M 16G,环境是Ubuntu 24.04.2! r! j* x' [2 k1 o% b
输入大概是10不到一点,输出大概是5,勉强可用! a4 h/ S! @% o; V
因为都是整的垃圾配件,总体的成本大概不到4000人民币
0 r' C# m% D- L9 D% Q( ~' O+ k
- ^$ e7 k" `' s( t. r) e我估计如果他能够用DDR4+至强的话,应该可以到7-8的输出7 }- L. D! O* j8 _7 r
如果是这个速度的话,个人轻量使用已经没有特别大的问题了
作者: 数值分析    时间: 2025-3-10 23:42
这里有篇文章是谈万元以下服务器部署DeepSeek-R1 671B + KTransforme的$ U9 {+ O/ v  M8 ~5 f
https://www.pmtemple.com/academy/17340/
/ Z( M+ Q9 d" X* b
作者: 孟词宗    时间: 2025-3-11 01:50
大黑蚊子 发表于 2025-3-10 22:25
, y1 G- I# ]- j, J- }" g刚刚看到一个案例,有个朋友用2686V4 x2 加256GDDR3跑起了671B的Q2.51版本& g+ A& a/ D( N8 d8 V9 ~3 w" j1 F) v$ w1 C
显卡用的是3070M 16G,环境是U ...

& b8 s3 P& G% a# M8 `$ Q
" q8 q7 c' r1 [. Z7 a我觉得别对Q5以下的版本抱太大希望。Q5 以下只能说是能跑,但效果实在不敢恭维,很多情况下出来的回答都不是 AI 幻觉,而是文不对题。在决定投钱搞硬件前,还是建议先化小钱租个服务器,下载不同的压缩版看看效果再确定要用哪一版,用什么本地硬件。
作者: 沉宝    时间: 2025-3-11 02:12
大黑蚊子 发表于 2025-3-10 22:25
; L8 d, x8 s9 a: Z. v8 T刚刚看到一个案例,有个朋友用2686V4 x2 加256GDDR3跑起了671B的Q2.51版本4 E! ^" k' K( C% H
显卡用的是3070M 16G,环境是U ...

) z5 u! ~8 e* {0 w这做得很厉害了。点赞!
作者: 沉宝    时间: 2025-3-11 02:14
数值分析 发表于 2025-3-10 23:42; p* w6 P3 ~; @. r, p+ ~7 ~
这里有篇文章是谈万元以下服务器部署DeepSeek-R1 671B + KTransforme的% j; J- F& N, V* I: Q2 \
https://www.pmtemple.com/academy/ ...

7 Y2 ~. O' A; S+ E* o5 n这么多案例,很有参考价值。
作者: 孟词宗    时间: 2025-3-12 01:39
有 512 GB RAM 的话,基本 Q3 以下都可以跑。Huggingface 上量化版不少。例如这个:https://huggingface.co/unsloth/DeepSeek-R1-GGUF 从 Q1 到 fp16 都齐全了。Q1 的几个版本甚至只要 256 GB 就可以跑了。
6 N) l0 Q' y1 P  k  T  |, Z9 ^1 Z2 w& z5 u2 n
但是,量化版压缩了尺寸,同时也压缩了功能。个人感觉 Q5 以下基本都是渣渣,回答大多逻辑不通。
作者: 孟词宗    时间: 2025-4-15 10:41
大黑蚊子 发表于 2025-3-10 22:25
1 S: a- G( B% [3 m7 K( w刚刚看到一个案例,有个朋友用2686V4 x2 加256GDDR3跑起了671B的Q2.51版本; r2 n( y+ D: p
显卡用的是3070M 16G,环境是U ...

% Q$ C# W9 ?# U# N- e" O, Q0 G性价比更好的是 HP Z840。这玩意儿有2X Intel Xeon E5-2678 v3 up to 3.1GHz (24 Cores Total),最好的是有16条内存槽,按 Intel 的说法,每个 CPU 可以到 768 GB DDR4。两个就是 1.5TB (实际 HP Z840 号称能到 2TB),正好可以跑 DS-R1 671b 完整版了。
作者: 雷声    时间: 2025-4-15 11:18
孟词宗 发表于 2025-4-15 10:41
( `' v. ^( I! S' h4 b4 t性价比更好的是 HP Z840。这玩意儿有2X Intel Xeon E5-2678 v3 up to 3.1GHz (24 Cores Total),最好的是 ...
, [6 d- |# Y4 S- W/ h- f9 A: t) X$ W
https://cloudninjas.com/collecti ... 40%20will%20support,Reduced%20server%20(LRDIMM)%20memory.! D) L4 W0 D/ g+ O2 C
' r' S  N% M2 {- [0 w; ?" A9 b; v' a
The HPE Z840 will support 4GB, 8GB, 16GB or 32GB DDR4 Registered.
  x( C/ Z' {  y. _# bThis server will also support 32GB, 64GB or 128GB Load Reduced Modules (LRDIMM). ! O' o( h. Y# X9 |/ M4 ^
The Maximum amount of RAM the HPE Z840 server can hold is 2TB (16 x 128GB) of Load Reduced server (LRDIMM) memory" K1 j% I8 t: ]1 _& W, }

/ g- R6 {: U+ y5 n7 S( vLRDIMM 128GB的话一条要1400~2000刀,16根的话。。。。 好像也不便宜了。3 V2 @' q( n% V
Z840倒是不值几个钱。
作者: 孟词宗    时间: 2025-4-15 11:58
本帖最后由 孟词宗 于 2025-4-15 12:01 编辑 $ z6 _) u# j9 e/ N6 q5 ?7 G
雷声 发表于 2025-4-15 11:184 x- C- H  d- m+ j
https://cloudninjas.com/collecti ... E%20Z840%20will%20s ...
, r0 N  i2 ?; v+ u3 Y, s6 ~( x
* l$ x4 e  u3 Z
没那么贵,Amazon 上一条才 $239。16条也就$3,824。
1 i5 G: J0 \1 Z! P3 _# K0 l5 g5 L% g. a$ h& u: h6 o! R# u
https://www.amazon.com/Tech-2666 ... cp-nq_eMQV&th=1( }7 k% U9 h$ h0 k" B) b# V
2 g) _3 \/ J3 n* c. B( y
1TB 的kit 稍微便宜一点, $1,908, x2 就是 $3,816: https://www.amazon.com/Tech-8x12 ... amp;sr=1-1&th=12 K* F) @. _) o9 R: k

& t0 H) g2 e: f: c但如果上 2TB 的kit 反而要 $4,319 : https://www.amazon.com/Tech-16x1 ... ctronics&sr=1-6$ N7 }. b& l' {

! M; r% S1 S0 y5 C7 L" i: a
) A3 T, N9 `2 A% k7 M( j9 {当然,真要上这个,最好买以前和卖家咨询一下,这些 RAM 是否可以装 Z840。我估计 Z840 出来这么多年,大概最多也就有人装到 128 GB,毕竟这不是 server 而是个工作站而已。
作者: 孟词宗    时间: 2025-4-15 12:14
雷声 发表于 2025-4-15 11:18
" J6 c2 U+ K0 {, ohttps://cloudninjas.com/collecti ... E%20Z840%20will%20s ...

# F/ f1 J& Y9 H6 P$ |* J1 i2 O! q/ |7 U% y# i* @# T
顺便说一句,如果只是要跑压缩版的话,我在另一个帖子(http://www.aswetalk.net/bbs/foru ... read&tid=161700)里已经说过,如果有192GB的 RAM 就可以跑 IQ1_S(131 GB), IQ1_M (158GB)(假设没有显卡加成)。' e$ a4 D" Z  ~- t% t7 H% i! S  k0 g

2 S# j0 Y- S* n0 z* Y* r不要显卡的话,搞个Intel core ultra 9 285k 或者 AMD Ryzen 9 9900x3d 加上 192GB DDR5 和 4TB 的 SSD,一般也就 $1,500 左右就搞定了。
作者: nanimarcus    时间: 2025-4-15 12:58
散热的问题,你把机箱敞开,左右两片直接给拆了,开个小风扇对着吹就是了,斜着吹,从前往后,CPU显卡电源一起吹,别去搞太复杂的冷却方案,水冷复杂且容易坏。
- D+ S6 U: B0 @; S% c当然,有点吵,放在别的房间,用网络连接好了,命令行,远程桌面都可以。
( Y% Q+ c! d: i0 S* }服务器那种结构就是隐含你用那种暴力风扇,对散热并不友好。! N' C+ z2 G8 |7 W0 s, d# b* R
我的GPU上的CUDA跑满都可以控制在80度以下。# b2 M3 W7 ^$ M% y# b8 X, \4 K8 P
当然奢侈一点,放在空调房,调节一下空调出口,把机箱放在桌子上,对着机箱吹能降下很多,这才是真正的水冷加风冷。
作者: 孟词宗    时间: 2025-4-15 13:48
如果是为了跑本地大模型,显卡没有必要搞顶级的家用卡。相比速度,更重要的是显卡的显存有多少。
3 s& g3 [8 L. ]) T0 E( t& Q4 e+ n0 f  h! ]" W/ z; [, E( K% x- t
从性价比来说,两块3090比一块4090要好,这是因为3090仍然支持 NVLink。连接后显存会显示为 48 GB。这就可以容纳很多模型了。/ ^7 H2 u; G/ L) [: r7 t- h& Z( f

- E  u5 u1 ^( ]$ T; g但3090的问题是功耗, 350W 起步,两个就是700W,对电源要求高了。而且还得找有足够空间的主板和机箱。而且价格也不便宜。4090 现在给炒到 3650 美刀左右,3090 则是 2000 美刀。加起来就不是小数字了。, y& ?! u5 `( F0 f

( D4 p8 e" O, [, b1 d+ \" {0 u对于显卡,我倒是推荐这个:PNY RTX 4000 Ada VCNRTX4000ADA-PB 20GB, 市价1500 美刀左右,有20GB。虽然不能串联,但这是个 Single Slot card。一般好的主板能塞三四个。功耗单卡才130瓦,三个加起来也就才相当于一个3090。而三个卡加起来 60 GB,Ollama 可以跑很多 LLM 了。$ q) U' A9 X; v' {' {

2 B" s: a! S5 g否则也可以弄个 PNY NVIDIA RTX 4500 Ada Generation 24GB GDDR6,这也就2300美刀左右,但显存和4090 一样。两个加起来相当于一个 4090 但显存要多一倍。
/ i5 n6 W! B1 d( G7 Y  }' q; y6 N* N5 L
当然,俺的理想卡是公布但还没有正式开售的 RTX PRO 6000 Max-Q https://www.pny.com/nvidia-rtx-pro-6000-blackwell-max-q。这玩意儿有 96GB 显存,还可以用 NVLink 串联。最大可到四张卡384GB,而单卡功耗不过 300W。9 H* ]8 P3 {9 ~/ L& {: a

+ M" M. P6 }, t% \4 j+ H' r当然价格据说也挺感人,要 $8,565 单张。
作者: 孟词宗    时间: 2025-4-15 14:12
nanimarcus 发表于 2025-4-15 12:58
( [8 i' H9 y8 a1 v# G( g) a* l6 D散热的问题,你把机箱敞开,左右两片直接给拆了,开个小风扇对着吹就是了,斜着吹,从前往后,CPU显卡电源 ...

0 {6 {% v$ t. I同意风冷,但用不着这样 DIY。可以用 联力 LANCOOL 215 https://lian-li.com/product/lancool-215/。这机箱正面两个200毫米的风扇吹气,后面一个140毫米的抽气,足够用了。用风扇的时候,机箱应当关上,这样风速比敞开的更快。
: P) p2 b$ z$ y" A; M. F
* }+ u2 [8 b( W' P1 W8 t# UCPU 和 显卡的冷却还是不能省的。倒不是风扇,而是它们的散热片不能省。有了散热片才能有效散热。风扇本身是不是装在CPU和显卡的散热装置上不重要。
作者: nanimarcus    时间: 2025-4-15 17:35
孟词宗 发表于 2025-4-15 14:125 q, ?' m7 p6 t  g. z* Q6 \
同意风冷,但用不着这样 DIY。可以用 联力 LANCOOL 215 https://lian-li.com/product/lancool-215/。这机 ...
+ O! j% C2 k9 `5 {6 r7 y& A
我有点成见,总认为机箱上的风扇不够有力,呵呵。) `7 x# W* ~! J6 W0 r) @$ m$ l+ f
: r9 G9 ?+ j+ L2 j2 Z; i4 ?
所以总认为机箱敞开了另外架个风扇吹特别有力,至少视觉上如此。
: e" m/ p6 J, R3 u( _6 [2 L; b
/ O7 L4 {2 C" l1 R. ]- z# M所以我的理想型机箱就是一个框架,其他统统敞开了,吹!
$ u' r; E6 F8 ~1 G5 t( A" X
; {( p9 R8 F, Z9 h0 ]2 W另外,CPU上带的散热片过于庞大,多少会造成主板变形,所以我的机箱是平放的,如此一来显卡是竖起来的,这样两个最重的部分不会造成形变。
作者: 孟词宗    时间: 2025-4-15 21:45
nanimarcus 发表于 2025-4-15 17:35  R' H6 i" y$ ?, h
我有点成见,总认为机箱上的风扇不够有力,呵呵。- @' q: d1 E' A, _9 J: u
' U0 b# g5 V6 a
所以总认为机箱敞开了另外架个风扇吹特别有力,至少视 ...

  t7 a8 S/ g! z0 P$ x+ cCaseless 的 DIY 电脑现在也挺多的。散热和灰尘啥的不是问题。
* q8 o3 I$ J$ b  e+ W  c1 g9 p 6 G7 O( z$ v) i. c' B- y
4 w, b  y0 n& J: T
主要问题是像下面这个放桌上的,如果一不小心撒点饮料上去就容易把电脑废了。
9 W  k) w3 ~6 w- ` % p2 l' Q3 f5 c# o

% R" f3 W, Q) U! m所以一般都是挂墙上的。造的好点的话还是挺科幻感的。
1 Z: p) d2 b1 G8 ^; ]$ S
作者: nanimarcus    时间: 2025-4-15 23:26
本帖最后由 nanimarcus 于 2025-4-15 23:27 编辑
3 @6 r1 X# B& b* ^& D4 B
孟词宗 发表于 2025-4-15 21:45' o$ J1 V8 E* i8 n1 _% ^% s' e, r
Caseless 的 DIY 电脑现在也挺多的。散热和灰尘啥的不是问题。
. w$ X- a. k! o

* i! b9 F3 n3 z+ k  k3 m这个确实很赞。
. v  `) s* ^' I0 r0 y* i7 c; F+ D
) f: I* K: p) o; I/ J2 v" h# K* c第一三张好像放不了全尺寸显卡。
  ^; O* g( H& m! l5 b* y第二张全尺寸显卡的散热好像不太好。
作者: 孟词宗    时间: 2025-4-16 00:07
nanimarcus 发表于 2025-4-15 23:26
" p* H: T, X8 a$ I这个确实很赞。
' `" H3 W4 C; ^7 h! p0 B2 M" k4 S. j7 `
4 b4 Y7 l8 [7 Q0 f6 h8 ~第一三张好像放不了全尺寸显卡。
4 \! U% b* ?9 J1 s6 U9 R3 z
都是全尺寸显卡。第一、三两张中的显卡散热被魔改成水冷了。所以看不到明显的显卡。实际上两个机器应该都是双显卡。第二张的显卡问题不大。很明显不是80或90级别的。根据电源才600W来看,应当是3060或4060级别的。这个显卡的原装风扇还在,制冷应当还行。
作者: 雷声    时间: 2025-4-16 07:27
孟词宗 发表于 2025-4-15 11:58
* ^) n5 d+ ~6 W! q+ K$ u5 O$ _没那么贵,Amazon 上一条才 $239。16条也就$3,824。
/ J9 _( m' Q& s& v6 {6 w3 |; r3 h( l2 ]
https://www.amazon.com/Tech-2666MHz-PC4-21300-Wo ...

/ k9 T* Q: m* n) e3 F( tHP Z系列G4以后支持Intel® Optane™ Persistent Memory,买二手的话更便宜。不过表现怎么样就不好说了。# F1 @& L( d/ C2 X
Z6/Z8 G4也可以上到2TB,加上PMM的话更多,价格比Z840也贵不了多少。
$ x  t8 p$ H- Q; k: y话说Z系列是真不错,我09年买的一台Z8现在用的好好的,而且比公司配的新Alien还快。
作者: 孟词宗    时间: 2025-4-16 09:55
本帖最后由 孟词宗 于 2025-4-16 10:03 编辑 # |* z8 U. P6 U8 U* N
雷声 发表于 2025-4-16 07:27$ y6 p: }5 ]8 ]* |% @0 E1 G
HP Z系列G4以后支持Intel® Optane™ Persistent Memory,买二手的话更便宜。不过表现怎么样就不好说了。 ...

6 _* ^- D" w3 p& Y/ g# Q% c# T2 l: _
HP Z8 G4 号称可以最高支持 3TB 不过这得看 CPU。如果单个 CPU 只支持 768 GB的话,那两个 CPU 最多也就 1.5 TB。大多数旧的 HP Z8 G4 都最多 1.5 TB。$ d: L; P9 D, O& l
" q; W" w- P( R* _# M% W
性价比来说你说的很对,Z8 G4 的确更合算一些。尤其是不少旧机器本身就带了 1.5 TB。这比自己买要合算多了,也省事多了。
9 M( H* c; g9 J. x
2 o0 c0 n0 s+ j4 b从跑 LLM 的角度讲,应当是可以跑,速度勉强可以接受的程度。俺那个三年旧的机器,如果不用显卡,跑 DS-R1 的 70B 蒸馏版最快也就两三个token每秒。Z8 G4 跑DS-R1 的671B版本应当只会更差。毕竟内存更慢,模型更大,CPU更老。
作者: leekai    时间: 2026-4-18 21:09
我去年春节也攒了台x99 双路e5v4+256+2080魔改22g*2,硬盘因为以前装nas不用买,后来淘了Dell730 HP z440,用下来感觉单路CPU更合适。期间装了N多大模型,现在只剩ragflow+qwen 3.5 ,35b做map,27b做reduce,都刚好可以单卡运行。前两天刚跟风试了turboquant,效果挺好。今天发现qwen 3.6发布,并且有UD IQ4量化,正在下载准备试试。
$ |- R9 M& I; y7 f, j: G现在有更好的选择,IBM AC922,六块v100 16g准系统闲鱼上报5800元。
作者: 沉宝    时间: 2026-4-19 11:10
leekai 发表于 2026-4-18 21:09
) o+ M( z# i- P; v) y我去年春节也攒了台x99 双路e5v4+256+2080魔改22g*2,硬盘因为以前装nas不用买,后来淘了Dell730 HP z440, ...

3 k4 b/ W/ A7 V1 |) D2080和v100的优点是可以通过NVLink 获得很大的显存。缺点是缺乏 fp8 等先进架构的支持。不过看在那价格上,还能说什么呢?!
8 ]9 y* I' |+ Y6 r$ F2 F4 `" F. T+ H1 K1 o9 F, q( p/ T. P6 D2 c
今年较之去年,最大的一个变化是像小龙虾之类的智能体流行起来了。通过不断的自我进化,智能体在很多方面可以达到和超过简单使用混合专家模型(MoE)。而智能体的后台模型,如果想跑在自己的机器上,小一些的稠密模型其效果往往好于MoE。与人相比,智能体的AI对话中提示词的长度平均增长了许多倍,从而也就要求更强的KV缓存。如此turboquant正逢其时。0 |1 |' A" L% E

7 I' o0 i& l7 c$ y比TurboQuant更强的还有RotorQuant。感兴趣的话可以关注一下它在你使用的模型上落地的进展。
作者: 大黑蚊子    时间: 2026-4-20 13:43
回首这个帖子4 d3 I1 z. a. T
如果去年就下手干他1个T的ECC DDR5内存的话...8 |2 w) P" A1 C, `7 {2 a
7 U9 m7 C: C7 @$ \; j; y. q5 O6 T
俺就不用今年年初买个128G内存条那么心痛了
作者: leekai    时间: 2026-4-21 17:32
大黑蚊子 发表于 2026-4-20 13:43
2 n3 I- H+ s; u/ E& g9 B回首这个帖子$ y. V7 m/ V! K" ~: J
如果去年就下手干他1个T的ECC DDR5内存的话...
: {! L0 T2 l- \3 D; K* @  ?
我一直以为自己加钱换了512幸好前两年弄了几根1T 2T 4T的nvme还有SATA SSD,就是去年初看来看去没买氦气盘有点后悔。


欢迎光临 爱吱声 (http://www.aswetalk.net/bbs/) Powered by Discuz! X3.2